~/cases/research-benchLive
ResearchBench
Wie aus der einzeiligen Take-Home-Aufgabe „Baue einen NotebookLM-Klon“ eine vollständige Local-first-Forschungs-Workbench mit Rust/WASM, lokalen Embeddings und belegten Audio-Podcasts wurde.
→Oberfläche & Studio-Details
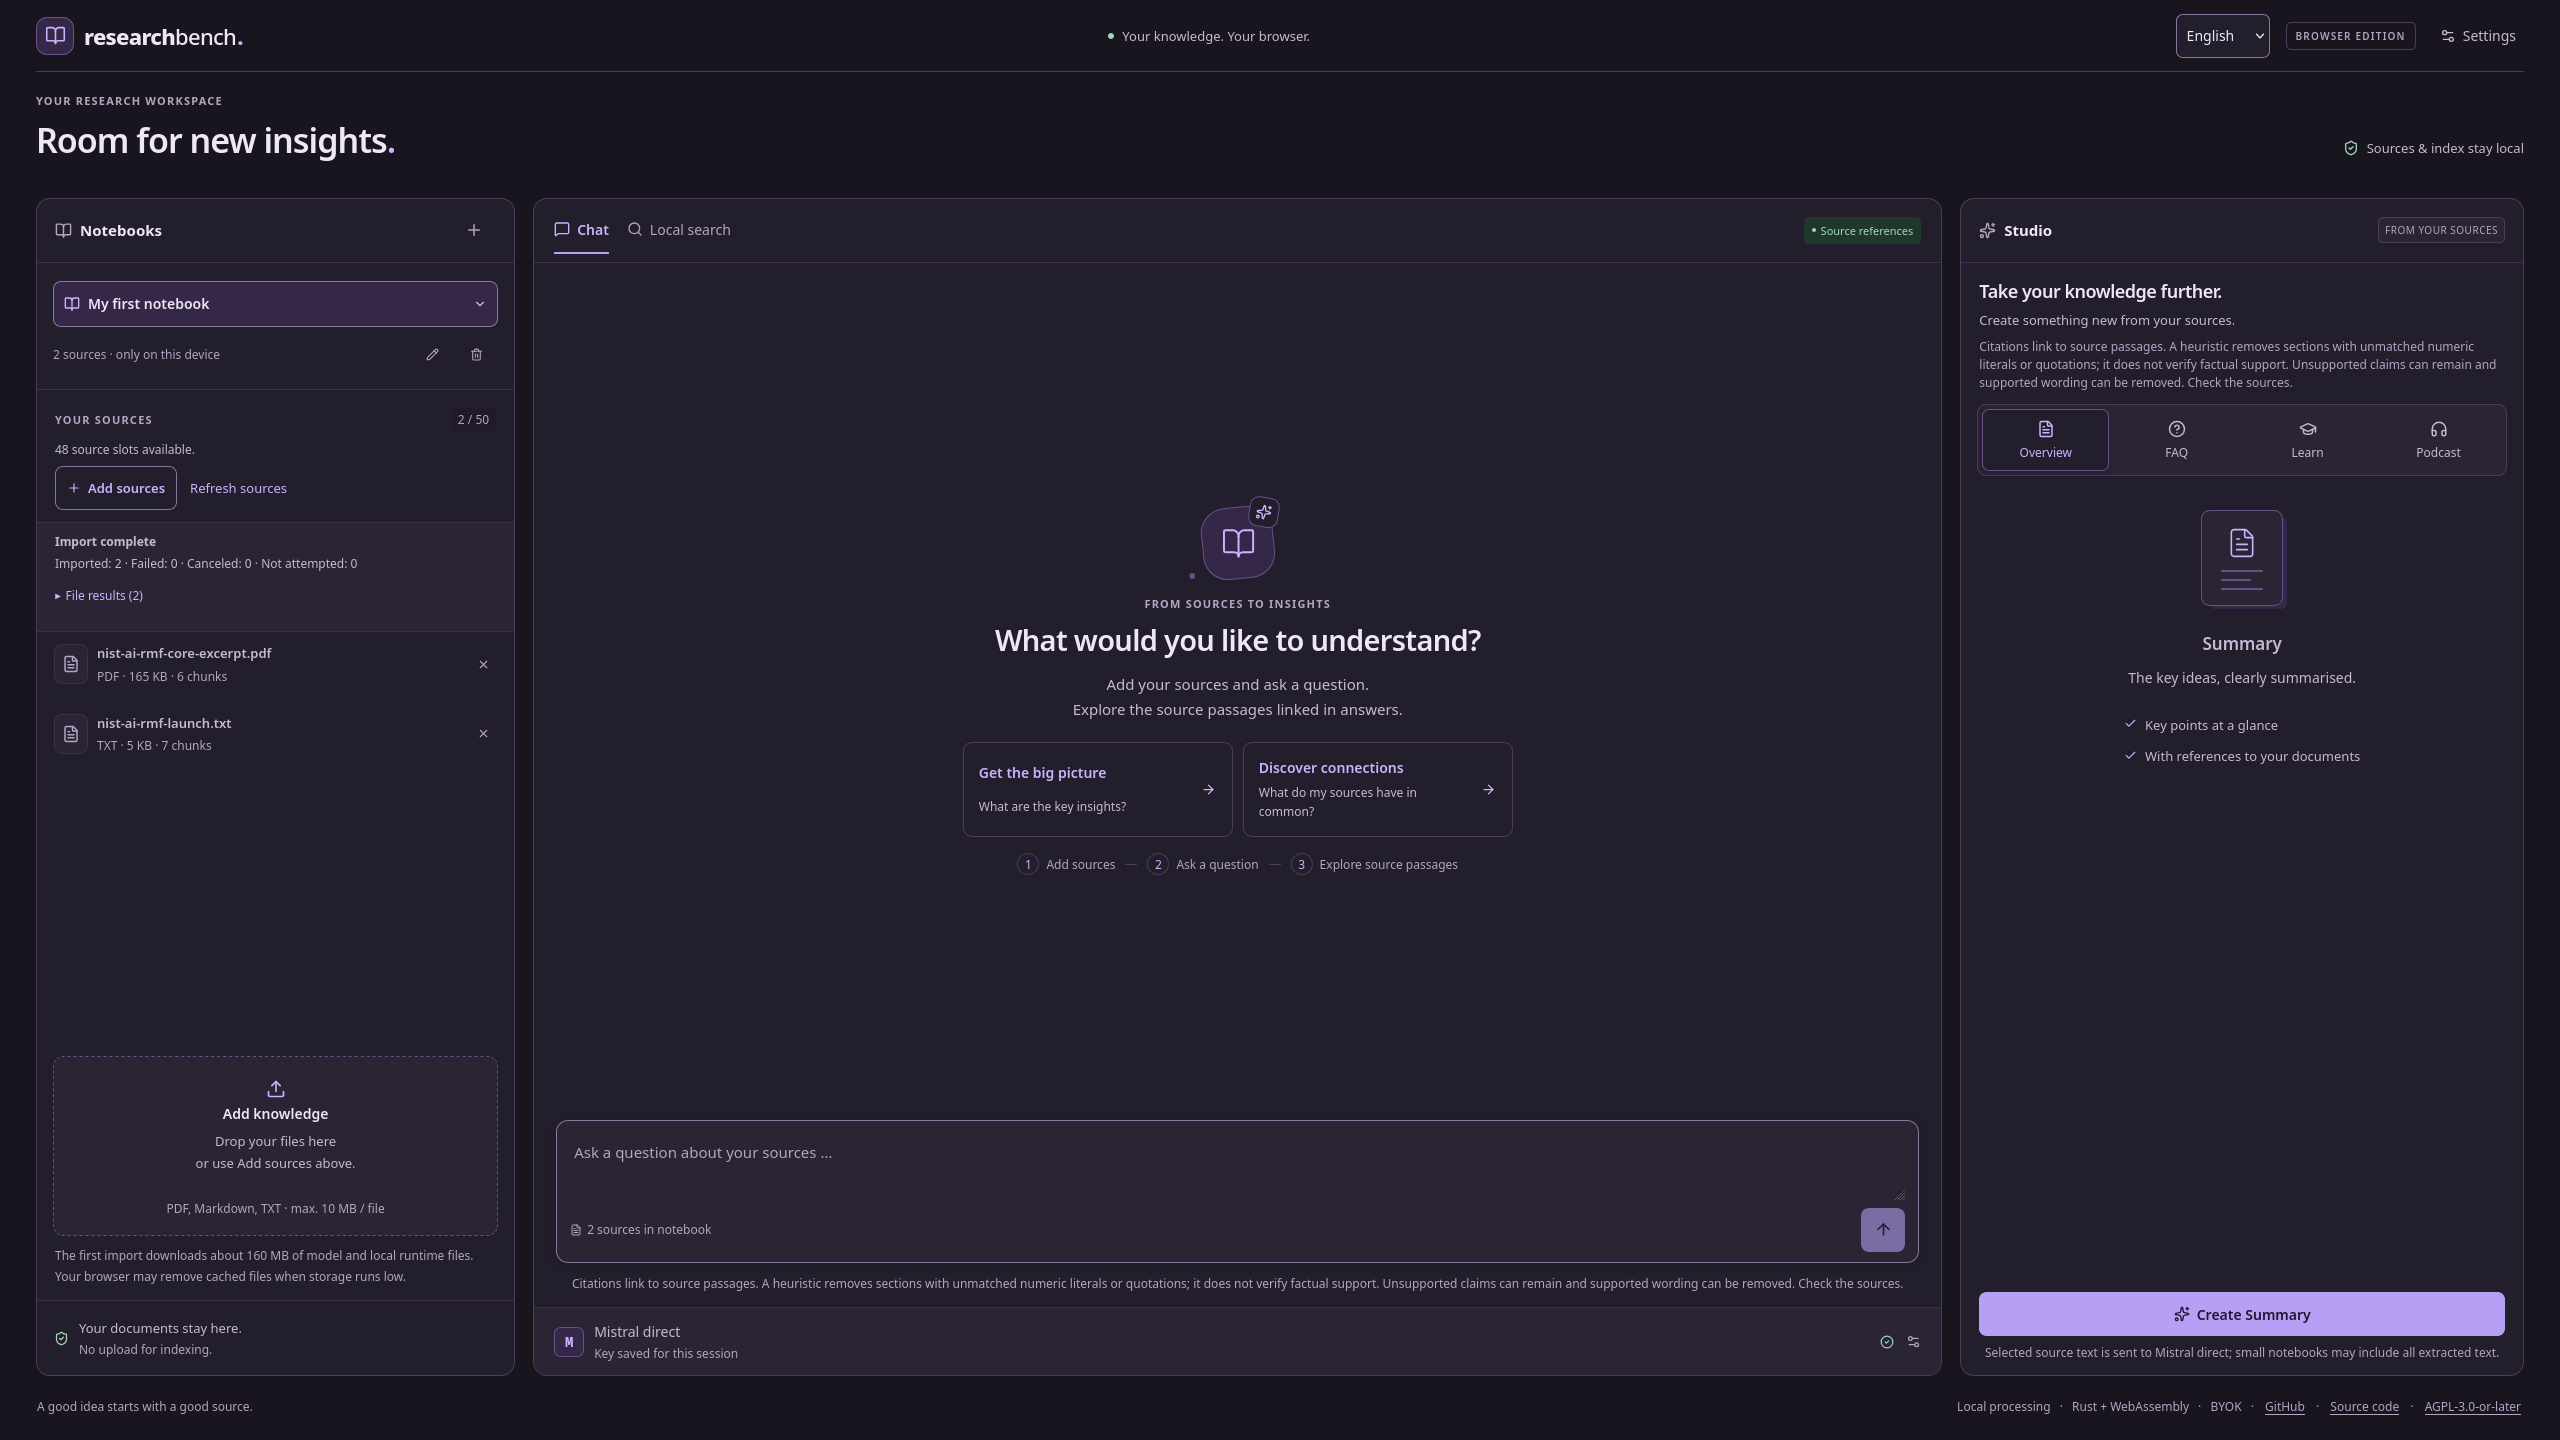
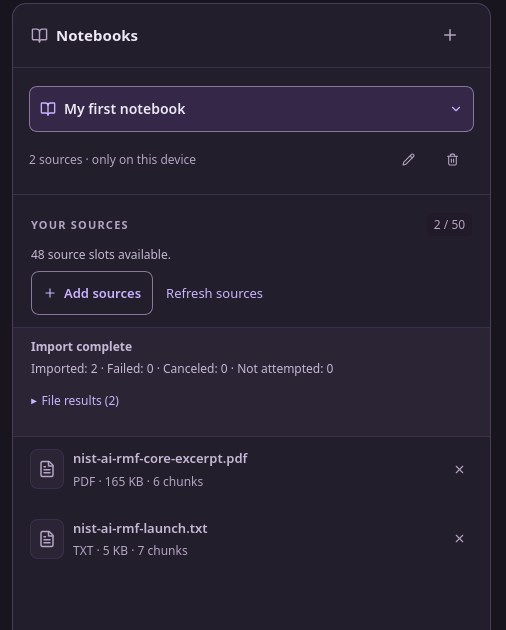
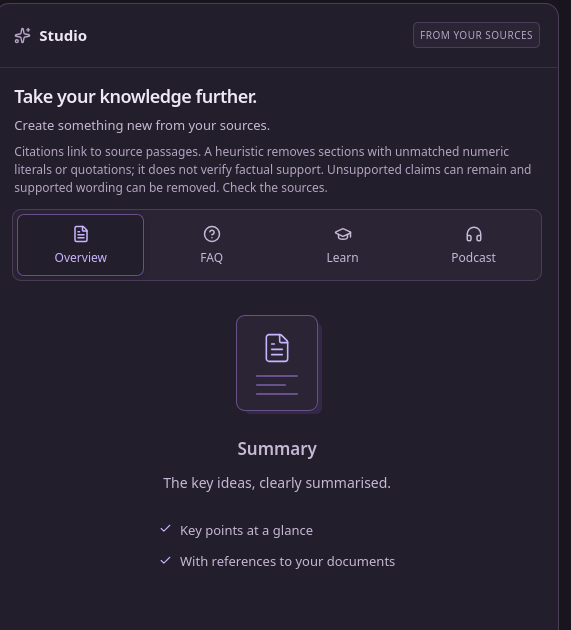
→Kontext
Die Aufgabe im Bewerbungsprozess war bewusst offen formuliert: „Baue einen NotebookLM-Klon. Umsetzung, Umfang und Struktur sind komplett Dir überlassen.“ Statt eine schnelle Chat-Oberfläche vor eine Server-API zu setzen, habe ich untersucht, wie weit sich der Kern-Workflow von NotebookLM komplett in den Browser verlagern lässt.
→Problem
Wer mit eigenen Dokumenten arbeitet, möchte nachvollziehen können, worauf sich eine generierte Aussage stützt, und nicht blind gesamte Dokumentensammlungen an ein Drittanbieter-Backend hochladen. Gleichzeitig müssen Zitate auf die exakte Stelle im Ausgangstext zeigen, statt nur ein Dokument pauschal zu nennen.
→Architektur
Dokumente verlassen beim Import und bei der Suche nie den Browser. Ein Rust-Crate mit gepinntem Pdfium-WASM extrahiert kanonischen Seitentext, erzeugt überlappende Chunks und berechnet halboffene UTF-16-Offsets. Ein Web Worker erzeugt lokale Embeddings mit einem quantisierten multilingual-e5-small-Modell unter ONNX Runtime Web. Notebooks, Quellen, Chunks und Vektoren werden mit Revisions-Checks in IndexedDB gespeichert.
Für Antworten, Zusammenfassungen, FAQs, Lernleitfäden und Podcast-Skripte ruft der Browser direkt den regionalen EU-Endpunkt von Mistral oder OpenRouter (mit ZDR- und Data-Collection-Deny-Filtern) auf. Vor der Anzeige prüft ein Support-Gate Zahlen und wörtliche Zitate gegen die übermittelten Quellpassagen; für Podcasts decodiert und normalisiert ein Audio-Worker die Sprachsegmente und encodiert sie lokal zu einer 24-kHz-MP3.
- PDF-, Markdown- und TXT-Dateien werden lokal im Browser über Rust und Pdfium-WASM in Seiten, Chunks und exakte UTF-16-Spans zerlegt.
- Ein ONNX-Runtime-Web-Worker berechnet lokale multilingual-e5-small-Embeddings und speichert alles atomar in IndexedDB.
- Chat und Studio führen die Kosinus-Suche lokal aus und prüfen Antworten über ein deterministisches Support-Gate.
- Nur für die Generierung und Sprachsynthese werden ausgewählte Passagen mit eigenem Session-Key an Mistral EU oder OpenRouter gesendet.
→Abwägungen
Die Local-first-Architektur spart jedes Anwendungs-Backend und hält Dokumente standardmäßig lokal, verlangt beim ersten Import aber den Download von rund 160 MB für Laufzeit und Embedding-Modell. Ebenso bleibt das Support-Gate eine ehrliche lexikalische Heuristik: Es fängt erfundene Zahlen und falsche wörtliche Zitate ab, behauptet aber keinen semantischen Wahrheitsbeweis.
→Entscheidungen & Trade-offs
| Entscheidung | Warum | Trade-off |
|---|---|---|
| Verarbeitung in Rust/WASM und Browser-Workern statt auf einem Server | Besucher können die Live-Demo sofort ohne Server-Setup oder Account nutzen; Import und Suche senden keinerlei Dokumentinhalte nach außen. | Speicher- und Laufzeitgrenzen des Browsers bestimmen die maximale Notebook-Größe (50 Quellen, 500.000 Zeichen, 1.000 Chunks). |
| Halboffene UTF-16-Spans vom Parser bis in die UI durchreichen | JavaScript-Strings nutzen UTF-16-Code-Units; durch die Berechnung direkt im Rust-Chunker öffnen Klicks auf Zitate exakt die markierte Textstelle. | Der Quellviewer arbeitet auf dem kanonisch extrahierten Text mit Seitenankern statt auf einem visuellen PDF-Canvas-Overlay. |
| Lexikalisches Support-Gate vor Anzeige und Sprachsynthese | Nur übertragene Kontext-IDs werden zu Links, und nicht belegte Zahlen oder wörtliche Zitate werden deterministisch gefiltert. | Ersetzt keinen semantischen Faktenbeweis und kann mehrdeutige Zahlenformate streng entfernen. |
| Wiederaufnehmbare Podcast-Synthese mit Web Locks und getrenntem Blob-Store | Ein Podcast benötigt bis zu 24 sequenzielle TTS-Aufrufe. Persistierte Einzelbeiträge und Web Locks verhindern doppelte Läufe über Tabs hinweg und erlauben ein exaktes Resume nach Fehlern. | Erfordert moderne Desktop-Browser mit Web Locks und Web Audio API. |
→Ergebnis
- Live-Deployment unter research-bench.nachtigall.dev mit vollständigem DE/EN-Interface, lokaler semantischer Suche, Chat, drei Text-Generatoren und zweistimmigem Podcast-Studio.
- 635 automatisierte Tests in v0.1.0 bestanden: 489 Vitest-Unit-Tests, 10 native Rust-Tests, 92 Playwright-E2E-Tests und 44 Security-/CSP-Tests über Chromium und Firefox hinweg.
→Nachweise
- Verifikation
- 635 Tests (v0.1.0)
- Lokale Pipeline
- 0 Backend
- Quellen-Präzision
- UTF-16-Spans
489 Unit · 10 Rust · 92 E2E · 44 Security (Chromium & Firefox)
PDFium-WASM, ONNX-Embeddings und Vektoren in IndexedDB
Klickbare Zitate und lexikalisches Support-Gate für Chat & Podcasts
→Was ich heute anders machen würde
Offene Aufgabenstellungen verführen dazu, möglichst viele Features oberflächlich anzureißen. Die klare Eingrenzung auf nachvollziehbare Quellen-Spans, saubere Abbruch-/Revisions-Semantik in IndexedDB und explizite Vertrauensgrenzen hat das Projekt deutlich stärker gemacht als ein breiterer, aber fragiler Klon.